Proximal Policy Optimization es uno de los algoritmos de Reinforcement Learning que mejor rendimiento han demostrado hasta el momento. En su funcionamiento y algunos ejemplos reales de aplicación se centró el meet up Applying Proximal Policy Optimization (Deep Dive).
En este encuentro abierto participó Álvaro Barbero, chief data scientist del Instituto de Ingeniería del Conocimiento (IIC), que comenzó explicando cómo funciona este algoritmo de aprendizaje por refuerzo en detalle.
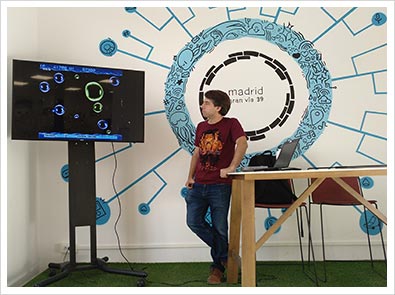 Antes dio una revisión histórica a los algoritmos de la familia Policy Gradients, que se han venido mejorando y perfeccionando con los años hasta resultar en Proximal Policy Optimization. Se presentaron tanto las bases teóricas de estos algoritmos como algunas explicaciones intuitivas sobre su forma de aprendizaje.
Tras la parte más teórica, compartió también algunas de las investigaciones realizadas desde el IIC para aplicar esta tecnología en proyectos de optimización de recursos.
La sesión fue organizada por MAD_RL_, un grupo de personas interesadas en el aprendizaje por refuerzo y la Inteligencia Artificial que prepara estas actividades habitualmente.
Puedes ver aquí la presentación de Álvaro Barbero en el meet up Proximal Policy Optimization.