Los grandes modelos de lenguaje, como GPT, Claude o Gemini, han alcanzado una gran capacidad para comprender y generar texto. Estos modelos comerciales solo están disponibles a través de las API de sus proveedores, con un acceso sencillo, pero con un coste que aumenta con cada uso. Además, enviar datos sensibles a un proveedor externo puede plantear problemas de privacidad y confidencialidad.
La alternativa es ejecutar en servidores propios un modelo abierto (open-source) de tamaño similar, como las versiones grandes de Qwen, Llama o DeepSeek. Pero estos modelos abiertos necesitan GPU de gama alta, con un coste de hardware considerable.
¿Es posible obtener resultados de calidad con modelos de lenguaje más pequeños, que requieran menos recursos para ejecutarse y puedan adaptarse a las necesidades de cada tarea? Esta es la pregunta que impulsa distAIllery: un proyecto que explora nuevas estrategias para entrenar modelos de lenguaje compactos y mejorar su eficiencia sin renunciar a una calidad adecuada.
Resultados de calidad con modelos del lenguaje pequeños
distAIllery propone un método en el que un modelo de lenguaje grande actúa como profesor y genera resúmenes de calidad. A partir de esos resúmenes se entrenan los “alumnos”, que son los modelos pequeños.
distAIllery combina técnicas de generación de datos sintéticos y fine-tuning supervisado, junto con un diseño experimental que tiene en cuenta las restricciones computacionales y permite evaluar tanto la calidad de los resultados como los recursos necesarios para obtenerlos. El objetivo es estudiar hasta qué punto esta combinación permite desarrollar modelos pequeños útiles para tareas específicas.
Como primer caso de uso, distAIllery se centra en el resumen automático de textos en español. Para ello:
- se parte de corpus existentes
- se generan nuevos resúmenes mediante un modelo de lenguaje de mayor capacidad
- se utilizan estos datos para entrenar modelos más pequeños.
- se evalúan los resultados obtenidos
- se comparan sus requisitos computacionales y costes con los de recurrir a un modelo comercial como GPT-4.1, incluida la posibilidad de ejecutar los modelos en CPU.
Este primer experimento permite explorar tres cuestiones:
- qué calidad pueden alcanzar los modelos pequeños
- en qué condiciones puede compensar entrenarlos frente a utilizar una API comercial y
- si es posible ejecutarmodelos de lenguaje pequeños sin hardware especializado.
Los experimentos ofrecen una primera respuesta. En noticias en español, casi todos los modelos pequeños obtienen notas muy próximas a las de GPT-4.1, incluso sin entrenamiento adicional.
El fine-tuning solo marca la diferencia en casos concretos, como el modelo más pequeño (Qwen3.5-0.8B) con textos jurídicos. En una GPU de consumo de 24 GB, resumir con estos modelos cuesta, en general, menos que usar la API de GPT-4.1. Además de que los datos no salen de la organización. En CPU, solo el modelo más pequeño se pudo ejecutar y únicamente resulta más barato en algunos casos.
Cómo se entrenaron los modelos pequeños
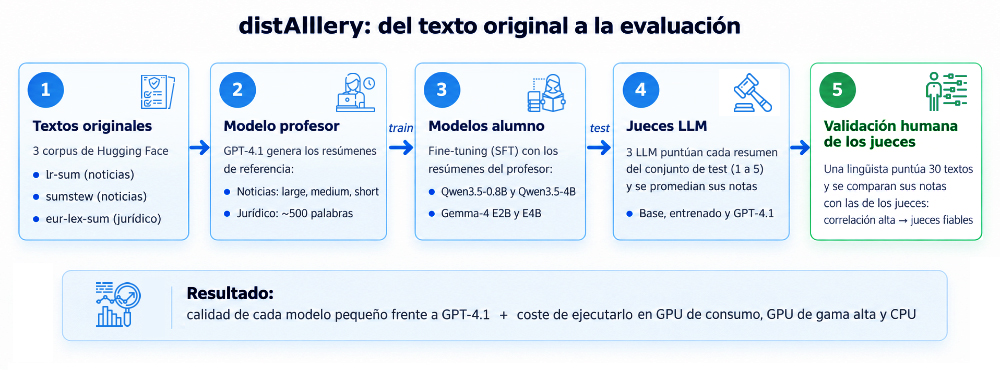
El punto de partida fueron tres corpus de HuggingFace ([LR-Sum], [sumstew] y [EUR-Lex-Sum]), que contienen textos y sus correspondientes resúmenes de referencia. Los dos primeros proceden del ámbito periodístico, mientras que el tercero reúne textos jurídicos.
Inicialmente, se planteó utilizar estos resúmenes como referencia para entrenar y evaluar los modelos de lenguaje pequeños. Sin embargo, durante la inspección manual de los datos, se detectaron problemas en una parte de las referencias, ya que no siempre presentaban la calidad ni el tipo de síntesis necesarios para utilizarlas directamente como objetivo de entrenamiento.
En los conjuntos de noticias, algunas referencias se parecían más a titulares o fragmentos informativos que a resúmenes del documento completo. En lugar de sintetizar las ideas principales del documento completo, algunas referencias se centraban únicamente en un hecho concreto o en una cita. Entrenar directamente con estos datos podía llevar a los modelos a reproducir ese patrón, priorizando información puntual en lugar de ofrecer una visión global del texto.
Algunos ejemplos muestran claramente el problema. En ciertos casos, la referencia era prácticamente una transcripción de lo que había contado un testigo:
«Iba andando y he empezado a oír golpes y gente corriendo. He visto gente por los aires y mucho polvo. Yo he entrado en un portal y he subido las escaleras huyendo.»
En otros, la referencia se centraba en una información concreta, sin que necesariamente quedaran representadas las ideas principales del documento original:
«El Departamento del Tesoro dice que Suiza y Vietnam manipulan sus monedas para obtener ventajas comerciales injustas. La administración de Joe Biden decidirá si mantiene esas designaciones.»
Estos casos pusieron de manifiesto una limitación importante de los datos de partida: disponer de un texto y de un resumen asociado no garantiza que este último sea una buena referencia para entrenar un modelo de resumen automático. Por ello, fue necesario plantearse cómo obtener referencias más adecuadas para la tarea.
Entrenar los modelos pequeños con resúmenes de calidad insuficiente
La idea clave de distAIllery
Se decidió cambiar el enfoque del proyecto. En lugar de entrenar los modelos pequeños con resúmenes de calidad insuficiente, se usa primero un modelo grande como modelo profesor: GPT-4.1.
- El profesor resume. GPT-4.1 recibe cada texto original y una instrucción con los criterios del resumen. Con esta información, genera un resumen nuevo.
- Se crea un corpus nuevo. Los resúmenes del profesor forman un corpus sintético que sirve de referencia.
- Los alumnos aprenden. Los modelos pequeños, o modelos alumno, se entrenan con este corpus mediante fine-tuning.
El objetivo es que los alumnos generen resúmenes de calidad, pero con un coste de ejecución potencialmente menor. Conviene aclarar que GPT-4.1 no se reentrena en ningún momento, solo se usa para generar los datos. El ajuste (supervised fine-tuning) se aplica únicamente a los modelos pequeños. El proceso, por tanto, combina la generación de datos sintéticos mediante un modelo profesor con la destilación de ese conocimiento hacia los alumnos a través de estos ejemplos.
Para estudiar cómo influye la longitud del resumen en los resultados, cada texto de los corpus de noticias se resumió en tres longitudes:
- Large: aproximadamente la mitad de la longitud del texto original.
- Medium: entre 60 y 100 palabras.
- Short: entre 40 y 60 palabras.
En el caso de EUR-Lex-Sum, los documentos jurídicos son considerablemente más largos y sus resúmenes de referencia originales más extensos. Por ello, en lugar de aplicar los tres niveles anteriores, se trabajó con una única longitud de alrededor de 500 palabras, más adecuada para este tipo de documentos.
De esta forma, los corpus de noticias permiten estudiar cómo afecta la longitud del resumen a la calidad de los resultados, mientras que EUR-Lex-Sum se utiliza como un caso específico de síntesis de documentos jurídicos extensos y especializados.
A partir de estos datos, se entrenaron cuatro modelos compactos: dos de la familia Qwen (Qwen3.5-4B y Qwen3.5-0.8B) y dos de la familia Gemma de Google (gemma-4-E2B-it y gemma-4-E4B-it). Su menor tamaño permite explorar hasta qué punto es posible obtener resultados útiles para esta tarea con modelos que requieren menos recursos computacionales que los grandes modelos comerciales.
https://huggingface.co/Qwen/Qwen3.5-4B | https://huggingface.co/Qwen/Qwen3.5-0.8B
https://huggingface.co/google/gemma-4-E2B-it | https://huggingface.co/google/gemma-4-E4B-it
Para evaluar su rendimiento, cada corpus se dividió en dos particiones, una para entrenar los modelos y otra, reservada para evaluarlos. Los resultados que se muestran a continuación se calculan sobre los textos del conjunto de test, que los modelos no han visto durante el entrenamiento.
Cómo se evaluó la calidad de los resúmenes
Una vez entrenados los modelos pequeños, se generaron resúmenes a partir de los textos del conjunto de test.
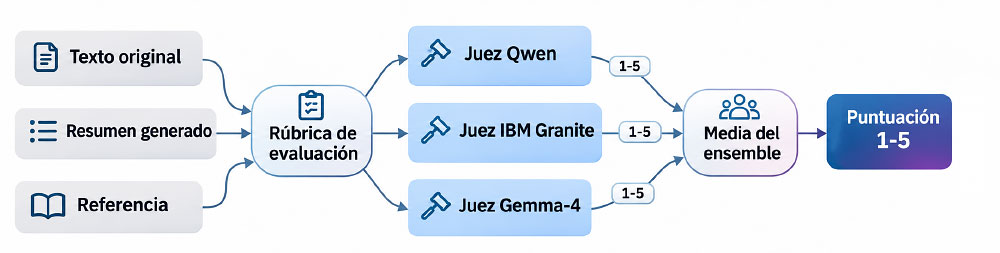
Para evaluar su calidad, se utilizó un ensemble de tres modelos jueces de tres familias distintas: Qwen3.6-35B-A3B de Alibaba, Granite-4.1-30B de IBM y Gemma-4-26B-A4B-it de Google. Cada juez recibe el texto original, el resumen generado y un resumen de referencia producido por GPT-4.1, y asigna una puntuación de 1 a 5 siguiendo una rúbrica que considera la fidelidad al documento original, la cobertura de la información relevante, la coherencia y la completitud.
La puntuación final es la media de las valoraciones de los tres jueces. Utilizar modelos de familias diferentes busca reducir la dependencia de un único evaluador y limitar posibles sesgos hacia las respuestas de una familia concreta.
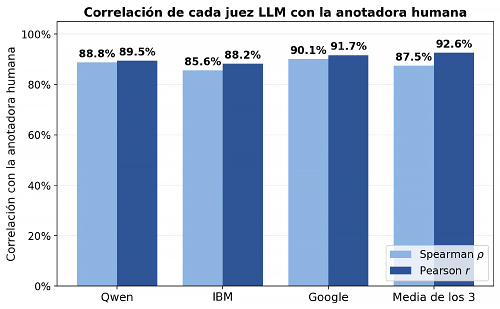
Además de este sistema de evaluación, una lingüista valoró manualmente una muestra de 30 textos. Sus puntuaciones se compararon con las de los tres jueces y se observaron correlaciones altas, lo que respalda el uso de esta evaluación automatizada, aunque no elimine por completo la posibilidad de discrepancias con el criterio humano.
De este modo, la evaluación no se limita a medir la similitud con los resúmenes de GPT-4.1, sino que también considera si los resultados son fieles al documento original y si recogen su información relevante.
¿Compensa entrenar un modelo de lenguaje pequeño?
La primera pregunta es cuánto aporta el fine-tuning cuando los modelos de partida ya tienen buenas capacidades de generación. ¿Permite mejorar sustancialmente sus resúmenes o basta con utilizar los modelos base tal como vienen?
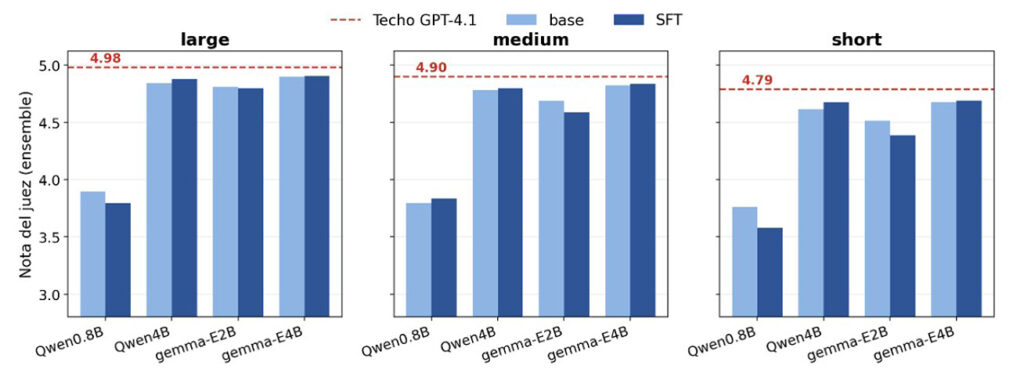
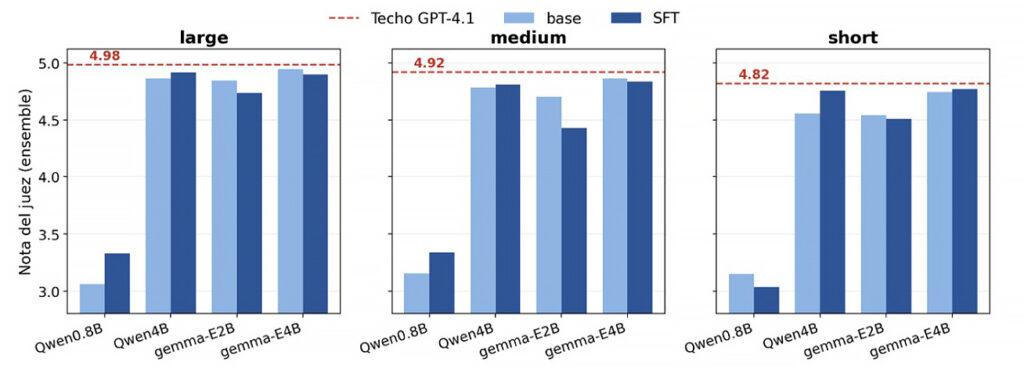
En los dos primeros conjuntos de datos (noticias) aparece un efecto techo. Salvo Qwen3.5-0.8B, tanto los originales como los ajustados, obtienen puntuaciones muy próximas al máximo de la escala. En estas condiciones, el margen de mejora es limitado.
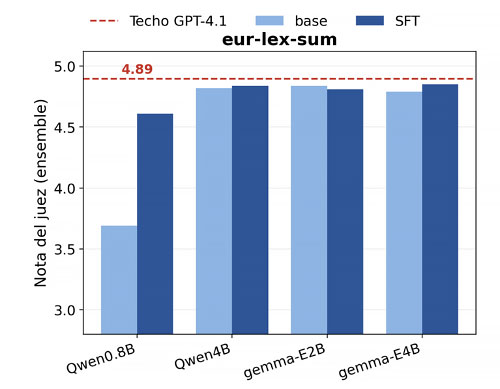
La situación cambia en EUR-Lex-Sum, el conjunto de documentos jurídicos. Qwen3.5-0.8B, el modelo más pequeño evaluado, mejora de forma notable tras el ajuste. En los demás modelos, las diferencias entre las versiones originales y las entrenadas son pequeñas, inexistentes o incluso favorables a la versión original, como sucede con Gemma-E2B.
Los resultados muestran que el efecto del fine-tuning depende del modelo y del tipo de documento. No se observa una relación simple según la cual los modelos más pequeños mejoren siempre más al entrenarse. En este experimento, el ajuste aporta poco cuando el modelo base ya resuelve bien la tarea, pero puede ser útil cuando parte de un rendimiento inferior, como ocurre con Qwen3.5-0.8B en los textos jurídicos.
¿Cuál es el coste de resumir con un modelo propio frente a GPT-4.1?
Además de la calidad, una de las motivaciones para utilizar modelos pequeños es reducir el coste de ejecución. Una vez entrenados, pueden desplegarse en infraestructura propia y generar resúmenes sin pagar una llamada a una API por cada texto.
Para estimar esta diferencia, se calculó el coste de generar los resúmenes del conjunto de test con cada modelo y se comparó con el coste de realizar la misma tarea mediante la API de GPT-4.1. Esta comparación permite estudiar el coste de ejecución de ambas alternativas en los escenarios evaluados.
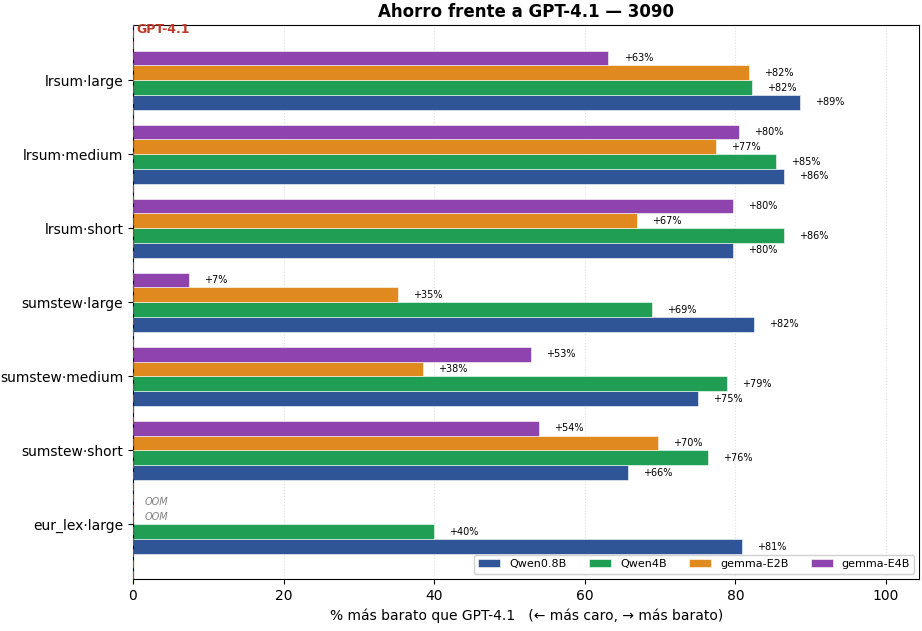
En una GPU de 24 GB de memoria, los modelos pequeños resultan, en general, más baratos que utilizar la API de GPT-4.1. Hay una excepción importante: los modelos Gemma no pueden ejecutarse con los documentos jurídicos de EUR-Lex-Sum en esa configuración, porque la memoria disponible es insuficiente.
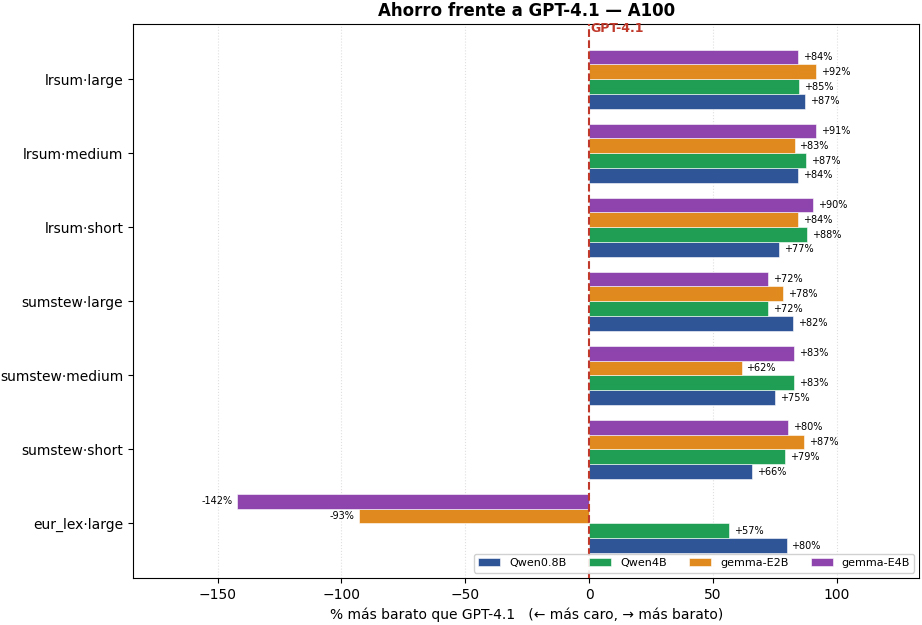
Al utilizar una GPU A100 con más memoria, los modelos Gemma sí pueden procesar esos documentos, pero su coste de ejecución resulta superior al de la API de GPT-4.1 en ese escenario.
Estos resultados muestran que el ahorro depende tanto del modelo como de la longitud de los documentos y del hardware disponible. Un modelo pequeño no es necesariamente la opción más barata en cualquier circunstancia, y su tamaño por sí solo no garantiza que pueda ejecutarse en una GPU de consumo.
¿Es viable ejecutar los modelos en CPU?
Por último, se exploró si era posible prescindir de una GPU dedicada. En las pruebas realizadas, solo el modelo más pequeño, Qwen3.5-0.8B, se evaluó con éxito en una instancia de CPU sin GPU, la c7i.2xlarge.
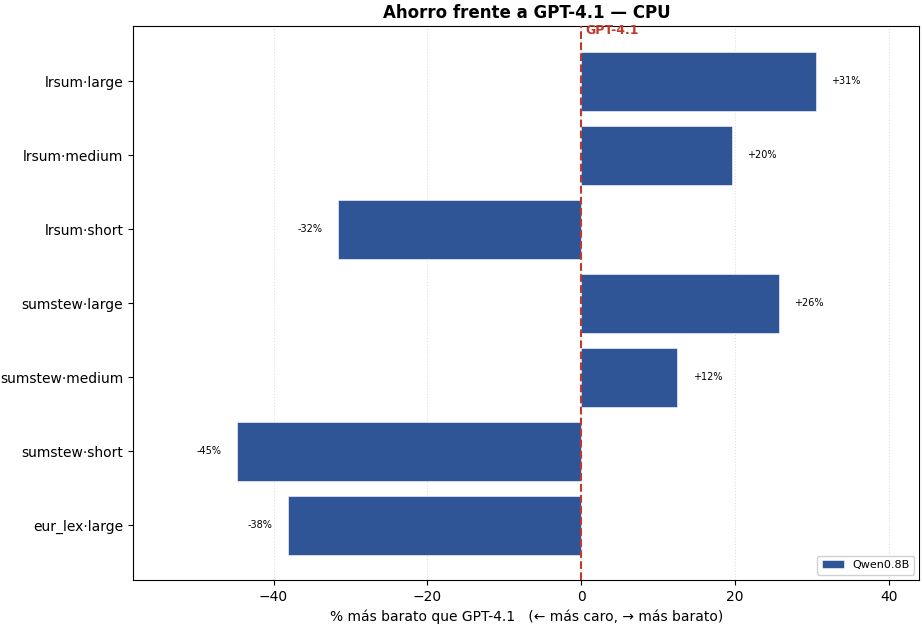
Los resultados muestran que esta alternativa solo resulta competitiva frente a GPT-4.1 en algunos escenarios. La CPU tarda considerablemente más en procesar los textos y generar los resúmenes, lo que aumenta el coste de ejecución cuando se calcula a partir del tiempo de uso de la máquina.
En EUR-Lex-Sum, la longitud de los documentos hace que procesarlos en CPU resulte especialmente costoso. En los resúmenes cortos de noticias ocurre algo diferente: el precio de la API de GPT-4.1 es muy bajo porque se generan pocos tokens, mientras que el modelo local sigue teniendo que procesar el texto de entrada. En estos casos, el ahorro desaparece.
Por tanto, prescindir de una GPU puede ser viable para determinadas tareas, pero no garantiza una reducción de costes. La longitud de los documentos, el tiempo de procesamiento y el precio de la alternativa comercial son factores determinantes.
Conclusiones: ¿compensa usar un modelo de lenguaje pequeño?
El principal hallazgo de distAIllery es que los modelos de lenguaje pequeños disponibles a principios de 2026 pueden resumir textos de noticias en español con resultados muy próximos a los de modelos como GPT-4.1.
En este conjunto de datos, los modelos base alcanzan puntuaciones prácticamente iguales al modelo profesor sin necesidad de ningún entrenamiento adicional.
Esto tiene una consecuencia práctica muy importante: para muchas tareas de resumen, basta con elegir bien el modelo pequeño y utilizarlo directamente, sin invertir en generar datos sintéticos ni ajustarlo. El fine-tuning queda para casos concretos en los que sí marca la diferencia como ocurre con Qwen3.5-0.8B en EUR-Lex-Sum.
La segunda conclusión es que ejecutar estos modelos en infraestructura propia reduce considerablemente el coste frente a la API de GPT-4.1, con la ventaja añadida de que los datos no salen de la organización.
El ahorro real depende del modelo, del hardware y de la longitud de los documentos. Con textos jurídicos largos, algunos modelos pueden superar la memoria disponible en una GPU de consumo, mientras que la ejecución en CPU puede resultar demasiado lenta. Por eso, antes de tomar una decisión, conviene evaluar cada modelo con documentos representativos y en el hardware previsto para su despliegue.
En resumen, un modelo de lenguaje pequeño puede ser una alternativa real a un gran modelo comercial, siempre que la decisión se tome evaluando conjuntamente calidad, coste y requisitos de ejecución. En este experimento se ofrece un método para hacer esta evaluación y determinar cuándo compensa cada opción.
Estos resultados corresponden específicamente al resumen automático en español. En otras tareas, sobre todo en aquellas donde los modelos base parten de un nivel más bajo, la estrategia de distAIllery de generar datos con un modelo profesor y ajustar modelos alumno podría aportar mejoras considerables. Explorar estos casos sería el siguiente paso natural del proyecto.
Post escrito por: Rodrigo González | Científico de datos en el IIC.